[딥러닝을 이용한 자연어 처리 입문] 요약정리
시작에 앞서
이 책은 전통적인 자연어 처리방법과 인공 신경망에 대해서 다룬다. 또한 텐서플로우의 케라스 API를 주로 사용한다. 1챕터부터 13챕터를 기본과정으로 하고 14챕터부터 19챕터를 심화과정으로 본다.
참고하여 볼것
동일 저자가 만든 PyTorch 학습 자료 : https://wikidocs.net/book/2788
이 책을 위해 제작한 이미지 자료 공유 (영리적 목적 제외 자유롭게 사용) : https://www.slideshare.net/wonjoonyoo/ss-188835227
딥 러닝 추천 자료 : https://www.d2l.ai/index.html
NLP 참고 자료 : http://www.phontron.com/class/nn4nlp2019/schedule.html, https://github.com/makcedward/nlp
한국어 NLP 논문 모음 : https://github.com/papower1/Awesome-Korean-NLP-Papers
목차
- 자연어 처리(natural language processing)란?
- 텍스트 전처리(Text preprocessing)
- 언어 모델(Language Model)
- 카운트 기반의 단어 표현(Count based word Representation)
- 벡터의 유사도(Vector Similarity)
- 토픽 모델링(Topic Modeling)
- 머신 러닝(Machine Learning) 개요
- 딥 러닝(Deep Learning) 개요
- 순환 신경망(Recurrent Neural Network)
- 워드 임베딩(Word Embedding)
- RNN을 이용한 텍스트 분류(Text Classification)
- NLP를 위한 합성곱 신경망(Convolution Neural Network)
- 태깅 작업(Tagging Task)
- 서브워드 토크나이저(Subword Tokenizer)
- RNN을 이용한 인코더-디코더
- 어텐션 메커니즘 (Attention Mechanism)
- 트랜스포머(Transformer)
- BERT(Bidirectional Encoder Representations from Transformers)
- 텍스트 요약(Text Summarization)
01. 자연어 처리(natural language processing)란?
자연어(natural language)란 우리가 일상 생활에서 사용하는 언어를 말한다. 자연어 처리(natural language processing)란 이러한 자연어의 의미를 분석하여 컴퓨터가 처리할 수 있도록 하는 일을 말한다. 자연어 처리는 음성 인식, 내용 요약, 번역, 사용자의 감성 분석, 텍스트 분류 작업(스팸 메일 분류, 뉴스 기사 카테고리 분류), 질의 응답 시스템, 챗봇과 같은 곳에서 사용되는 분야이다. 컴퓨터와 인간 언어 사이의 상호작용하는 기술로 인공지능의 핵심 기능중 하나다.
1) 필요 프레임워크와 라이브러리
윈도우 환경을 기준으로 두고 아나콘다(Anaconda)를 설치하는 방법과 인터넷을 통해 간편히 사용할 수 있는 실습환경인 구글의 코랩(Colab)이 소개되었다. (나는 이미 아나콘다가 설치되어있으므로 굳이 새로운 걸 깔지않고 그대로 진행한다.) 아나콘다를 설치했다면 기본적으로 Numpy, Pandas, Jupyter notebook, scikit-learn, matplotlib, seaborn, nltk 등이 이미 설치되어져 있다. 그래서 아나콘다에 포함되어있지 않은 tensorflow, keras, gensim 이 세 가지만 별도로 pip를 통해 설치하면 된다.
✅ 텐서플로우(Tensorflow)
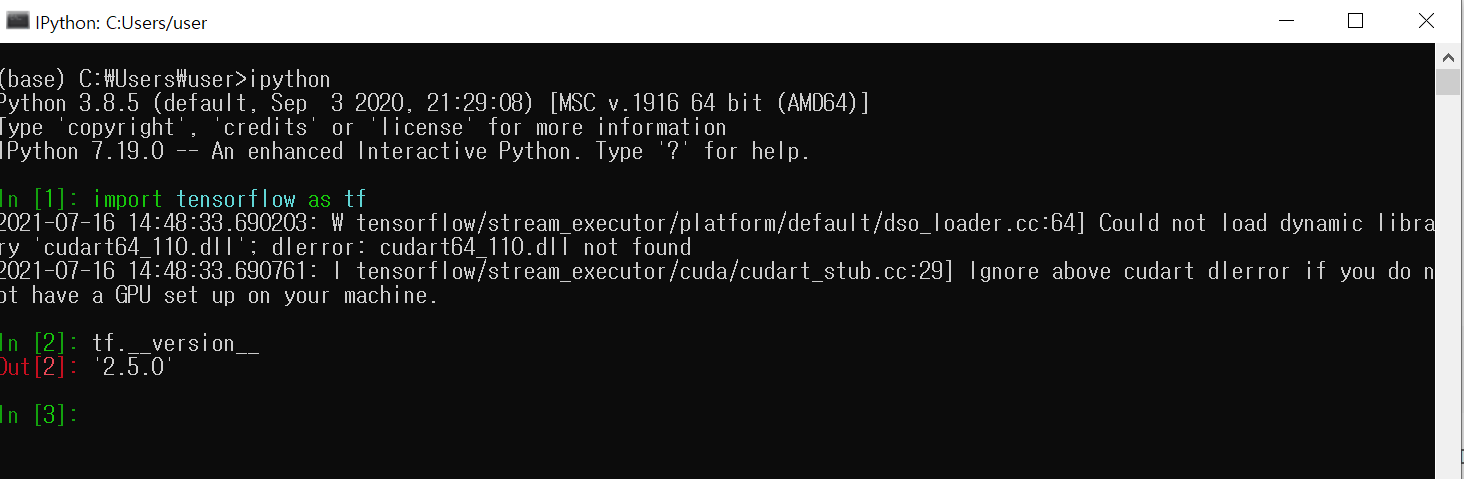
텐서플로우는 구글이 2015년에 공개한 머신 러닝 오픈소스 라이브러다. 머신 러닝과 딥 러닝을 직관적이고 손쉽게 할 수 있도록 설계되었다. 뒤의 딥 러닝을 실습을 위해서 텐서플로우를 설치해야 한다. 아나콘다 프롬프트(Anaconda Prompt) 또는 명령 프롬프트를 통해서 설치할 수 있다. 아나콘다 프롬프트를 열었다면 아나콘다 프롬프트에 아래의 커맨드를 입력하여 텐서플로우를 설치한다.
> pip install tensorflow
✅ 케라스(Keras)
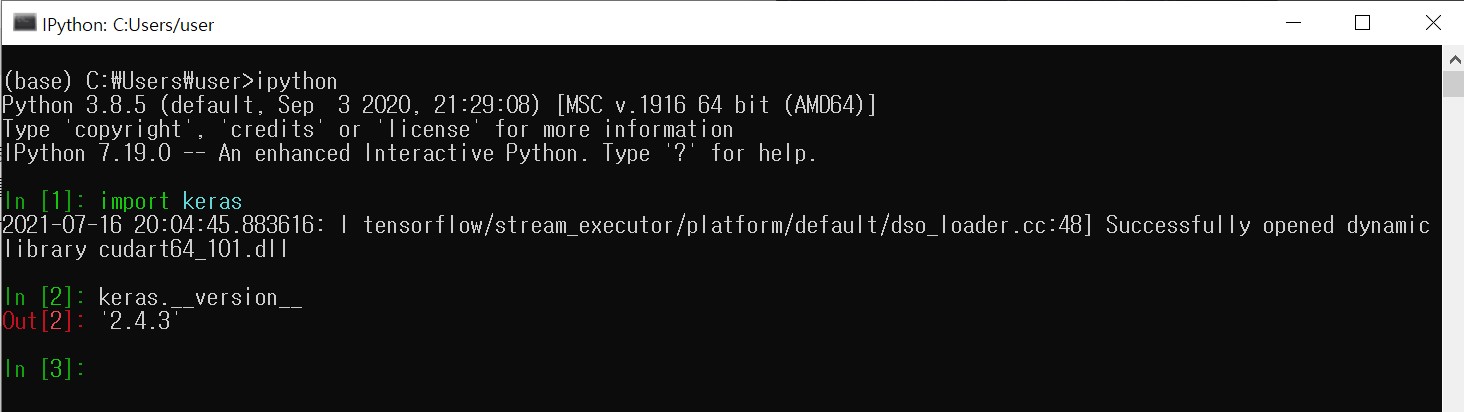
케라스(Keras)는 딥 러닝 프레임워크인 텐서플로우에 대한 추상화 된 API를 제공한다. 케라스는 백엔드로 텐서플로우를 사용하며, 좀 더 쉽게 딥 러닝을 사용할 수 있게 해준다. 쉽게 말해, 텐서플로우 코드를 훨씬 간단하게 작성할 수 있다. 사실 설치한 케라스를 사용할 수도 있지만, 텐서플로우에서 케라스를 사용할 수도 있다. 영어 커뮤니티에서는 순수 케라스를 keras라고 표기한다면, 텐서플로우에서 케라스 API를 사용하는 경우는 tf.keras라고 표기한다. 이 두 가지는 실제로 문법도 많은 면에서 같아서 keras 코드를 tf.keras로 변경하는 건 아주 쉽고, keras를 학습하였다면 tf.keras도 금방 익숙하게 사용할 수 있다. 케라스 개발자인 프랑소와 숄레(François Chollet)는 앞으로는 keras보다는 tf.keras를 사용할 것을 권장한다. 이 책은 keras와 tf.keras 두 가지 모두를 사용한다.
(케라스설치할때는 텐서플로우 설치할때랑 다르게 계속해서 오류가 뜨고 설치에 실패했었다.ㅠ그 원인을 알아보니 결국 케라스가 텐서플로우에 기반하기때문에 반드시 둘이 호환가능한 파일로 구성되어야 한다. 그래서 uninstall했다가 여러시도를 거듭한 결과, 설치성공했다!😁)
> pip install keras
✅ 젠심(Gensim)
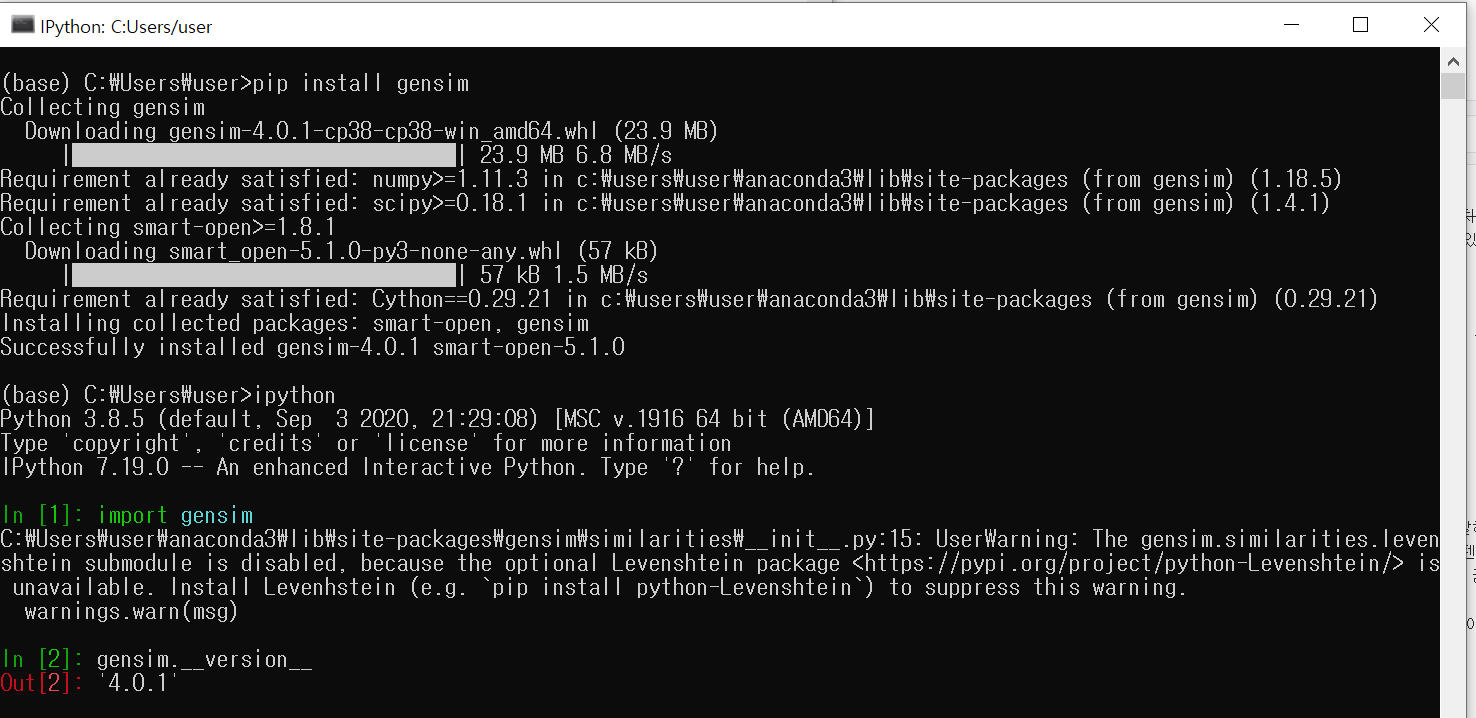
젠심(Gensim)은 머신 러닝을 사용하여 토픽 모델링과 자연어 처리 등을 수행할 수 있게 해주는 오픈 소스 라이브러리다. 이 책에서도 젠심을 사용하여 토픽 모델링과 Word2Vec 등을 학습해본다.
> pip install gensim
2) 자연어 처리를 위한 NLTK와 KoNLPy 설치하기
다음 챕터인 텍스트 전처리(Text preprocessing) 챕터에서는 전처리를 위한 이론에 대해서 학습하고, 그 이론을 바탕으로 실습을 진행하게 된다. 이번 챕터에서는 실습에 필요한 기본적인 자연어 패키지가 소개된다.
-NLTK는 자연어 처리를 위한 파이썬 패키지로 아나콘다가 설치되었다면 기본적으로 설치되어있다. 이때 NLTK의 기능을 제대로 사용하기 위해 NLTK Data라는 여러 데이터를 추가적으로 설치해야 한다. 이를 위해서는 파이썬 코드 내에서 import nltk 이후에 nltk.download()라는 코드를 수행하여 설치한다.
코엔엘파이(KoNLPy)는 한국어 자연어 처리를 위한 형태소 분석기 패키지다.
💡 Pandas, Numpy and Matplotlib 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/Pandas%20and%20Numpy%20and%20Matplotlib.ipynb
02. 텍스트 전처리(Text preprocessing)
자연어 처리에 있어서 텍스트 전처리는 매우 중요한 작업이다. 텍스트 전처리는 용도에 맞게 텍스트를 사전에 처리하는 작업이다. 요리에 있어서 재료를 제대로 손질하지 않으면, 요리가 제대로 되지 않는 것과 같다. 텍스트에 대해서 제대로 된 전처리를 하지 않으면 뒤에서 배울 자연어 처리 기법들이 제대로 동작하지 않다. 이 챕터에서는 텍스트를 전처리하기 위한 각종 기법에 대해서 배운다.
💡 Text preprocessing 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/2_Text%20preprocessing.ipynb
03. 언어 모델(Language Model)
언어 모델(Languagel Model)이란 단어 시퀀스(문장)에 확률을 할당하는 모델을 말한다. 어떤 문장들이 있을 때, 기계가 이 문장은 적절해! 이 문장은 말이 안 돼! 라고 사람처럼 판단할 수 있다면, 기계가 자연어 처리를 정말 잘 한다고 볼 수 있다. 이게 바로 언어 모델이 하는 일이다.
이번 챕터에서는 통계에 기반한 전통적인 언어 모델(Statistical Languagel Model, SLM)에 대해서 배운다. 통계에 기반한 언어 모델은 우리가 실제 사용하는 자연어를 근사하기에는 많은 한계가 있었고, 요즘 들어 인공 신경망이 그러한 한계를 많이 해결해주면서 통계 기반 언어 모델은 많이 사용 용도가 줄었다. 하지만 그럼에도 여전히 통계 기반 언어 모델에서 배우게 될 n-gram은 자연어 처리 분야에서 활발하게 활용되고 있으며, 통계 기반 방법론에 대한 이해는 언어 모델에 대한 전체적인 시야를 갖는 일에 도움이 된다.
1) 언어 모델(Language Model)이란?
언어 모델(Language Model, LM)은 언어라는 현상을 모델링하고자 단어 시퀀스(또는 문장)에 확률을 할당(assign)하는 모델이다. 언어 모델을 만드는 방법은 크게 통계를 이용한 방법 과 인공 신경망을 이용한 방법 으로 구분할수 있다. 최근에는 인공신경망을 이용한 방법(ex. GPT, BERT)이 더 좋은 성능을 보여주고 있다. 이번 챕터에서는 전통적인 통계적 언어 모델에 대해서 배운다.
=> 언어 모델: 단어 시퀀스에 확률을 할당(assign)하는 일을 하는 모델이다. 즉 언어 모델은 가장 자연스러운 단어 시퀀스를 찾아내는 모델이다. 단어 시퀀스에
확률을 할당하게 하기 위해서 가장 보편적으로 사용되는 방법은 언어 모델이 이전 단어들이 주어졌을때 다음 단어를 예측하도록 하는것이다.
=> 언어 모델링: 주어진 단어들로부터 아직 모르는 단어를 예측하는 작업을 말한다.
스태폰드대학에서는 언어 모델을 문법이라고 비유하기도 한다.
=> 검색 엔진에서의 언어 모델의 예를 생각해볼수 있다.
2) 통계적 언어 모델(Statistical Language Model, SLM)
=> 조건부 확률: 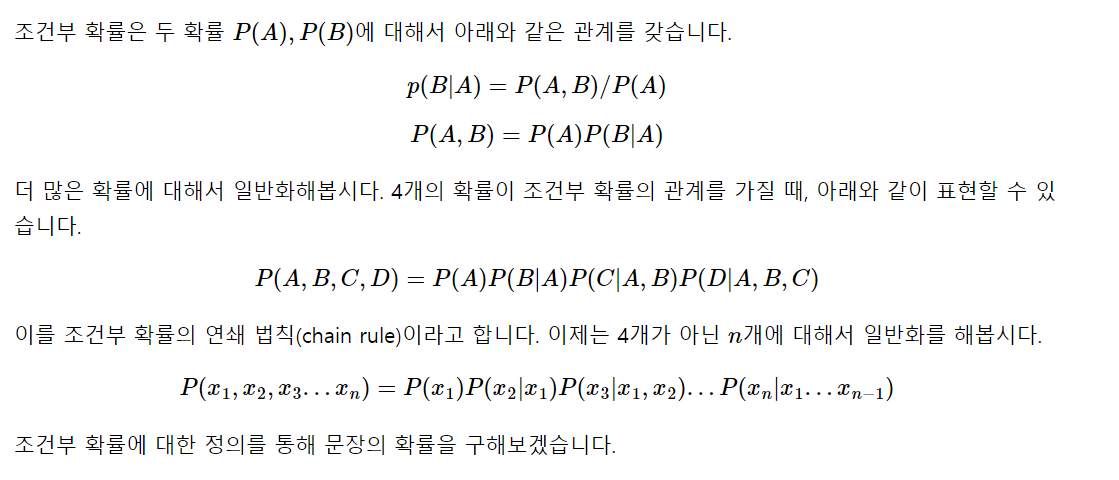
=> 문장에 대한 확률: 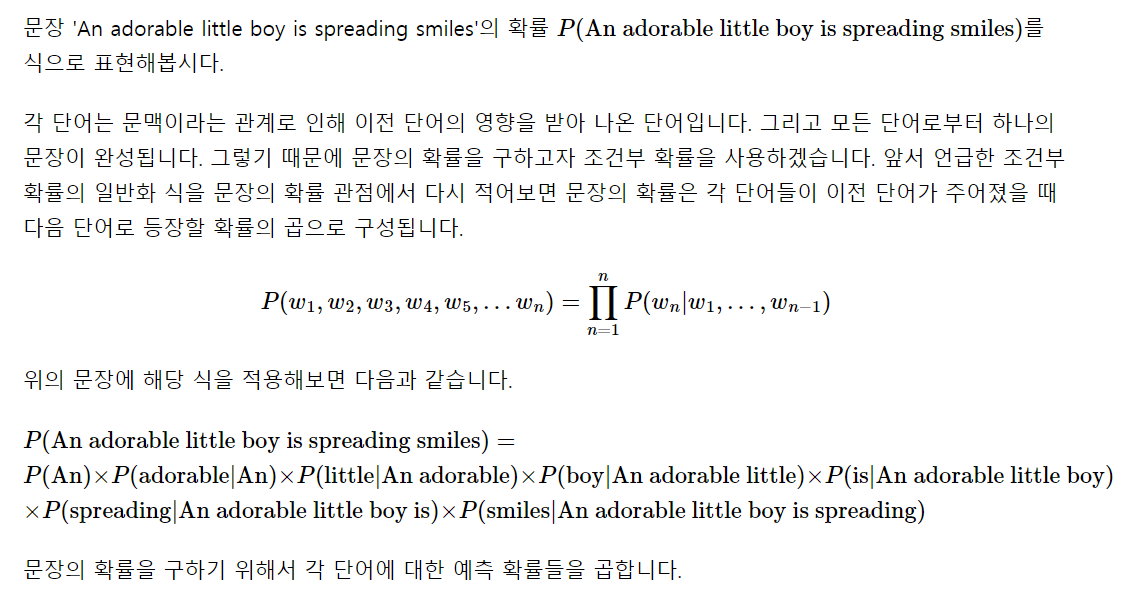
=> 카운트 기반의 접근: 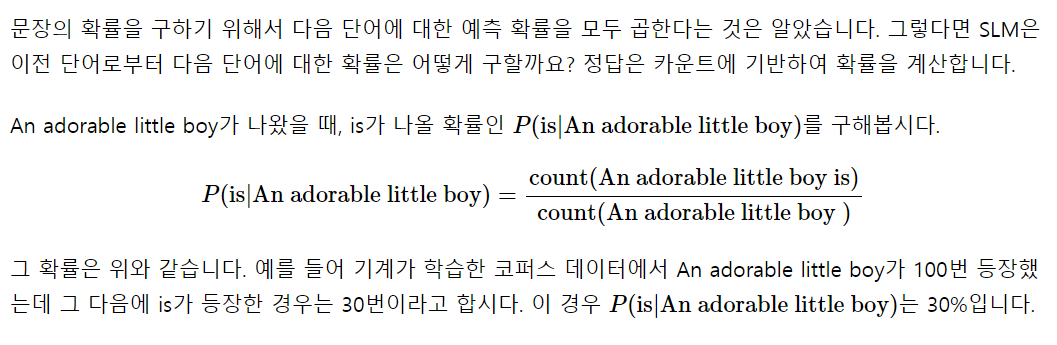
=> 카운트 기반접근의 한계- 희소 문제: 충분한 데이터를 관측하지 못하여 언어를 정확히 모델링하지 못하는 문제를 말한다. 코퍼스에 단어 시퀀스가 없다면 그 확률이 0 또는 정의되지 않는 확률이 되어버린다.
3) N-gram 언어 모델(N-gram Language Model)
n-gram 언어 모델은 여전히 카운트에 기반한 통계적 접근을 사용하고 있으므로 SLM의 일종이다. 다만, 앞서 배운 언어 모델과는 달리 이전에 등장한 모든 단어를 고려하는 것이 아니라 일부 단어만
고려하는 접근 방법을 사용한다. 이때 일부 단어를 몇개 보느냐를 결정하는데 이것이 n-gram에서의 n이 가지는 의미다.
=> SLM의 한계는 훈련 코퍼스에 확률을 계산하고 싶은 문장이나 단어가 없을수 있다는 점이다. 그리고 확률을 계산하고 싶은 문장이 길어질수록 갖고있는 코퍼스에서
그 문장이 존재하지 않을 가능성이 높다. 다시말하면 카운트 할수 없는 가능성이 높다. 그러나 참고하는 단어들을 줄이면 카운트를 할수 있는 가능성을 높일수 있다.
예를 들어, An adorable little boy에서 is가 나올 확률보다 boy에서 is가 나올 확률이 더 높을것이다.
=> n-gram은 n개의 연속적인 단어 나열을 의미한다. 이때 갖고 있는 코퍼스에서 n개의 단어 뭉치 단위로 끊어서 이를 하나의 토큰으로 간주한다.
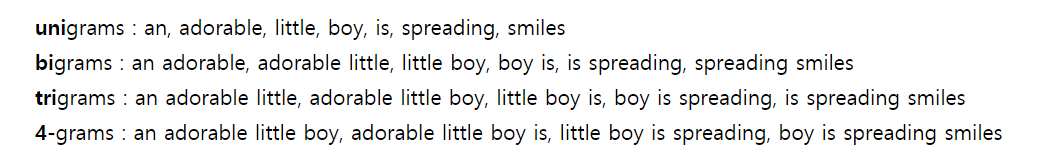
=> n-gram language nodel의 한계로는 희소 문제/ n을 선택하는 것은 trade-off문제 등이 있다.
=> 이 모델의 한계를 극복하기 위해 인공 신경망을 이용한 언어 모델이 많이 사용되고 있다.
04. 카운트 기반의 단어 표현(Count based word Representation)
자연어 처리에서 텍스트를 표현하는 방법으로는 여러가지 방법이 있다. 우리가 앞서 배운 n-gram 또한 텍스트를 표현하는 방법 중 하나이다. 하지만 머신 러닝 등의 알고리즘이 적용된 본격적인 자연어 처리를 위해서는 문자를 숫자로 수치화할 필요가 있다. 그런 측면에서 앞으로 4챕터, 6챕터, 10챕터에서는 문자를 숫자로 수치화하는 방법에 대해서 배우게 된다.
1) 다양한 단어의 표현 방법
우리는 카운트 기반의 단어 표현 방법을 다음 챕터인 Bag of Words챕터에서부터 배운다.
=> 단어의 표현 방법으론 크게 국소 표현(Local Representation/ Discrete Representation)방법 과 분산 표현(Distributed Representation/ Continuous Representation)방법 으로 나뉜다. 국소 표현 방법은 해당 단어 그 자체만 보고, 특정값을 맵핑하여 단어를 표현하는 방법이며, 분산 표현 방법은 그 단어를 표현하고자 주변을 참고하여 단어를 표현하는 방법이다. 예를 들어 puppy(강아지), cute(귀여운), lovely(사랑스러운)라는 단어가 있을 때 각 단어에 1번, 2번, 3번 등과 같은 숫자를 맵핑(mapping)하여 부여한다면 이는 국소 표현 방법에 해당된다. 반면, 분산 표현 방법의 예를 하나 들어보면 해당 단어를 표현하기 위해 주변 단어를 참고한다. puppy(강아지)라는 단어 근처에는 주로 cute(귀여운), lovely(사랑스러운)이라는 단어가 자주 등장하므로, puppy라는 단어는 cute, lovely한 느낌이다로 단어를 정의한다. 이렇게 되면 이 두 방법의 차이는 국소 표현 방법은 단어의 의미, 뉘앙스를 표현할 수 없지만, 분산 표현 방법은 단어의 뉘앙스를 표현할 수 있게 된다.
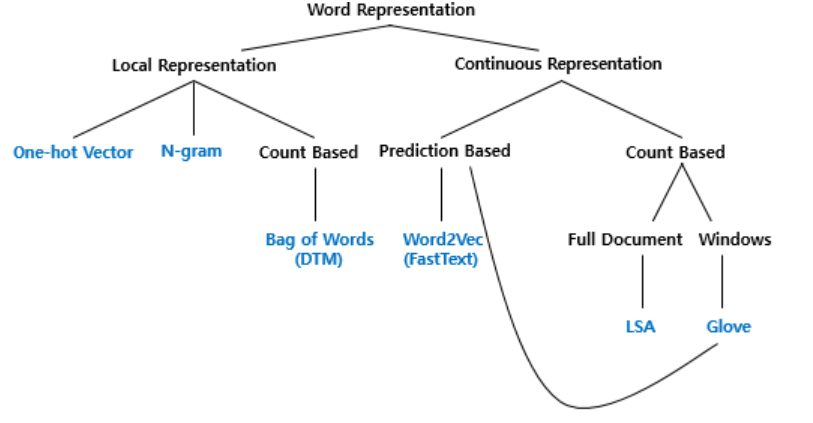
이번 4챕터의 Bag of Words는 국소 표현에 속하며, 단어의 빈도수를 카운트(Count)하여 단어를 수치화하는 단어 표현 방법이다. 이 챕터에서는 BoW와 그의 확장인 DTM(=TDM)에 대해 학습하고, 이러한 빈도수 기반 단어 표현에 단어의 중요도에 따른 가중치를 줄수 있는 TF-IDF에 대해 학습한다.
💡 Count based words 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/4_Count%20based%20words.ipynb
05. 벡터의 유사도(Vector Similarity)
문서의 유사도를 구하는 일은 자연어 처리의 주요 주제 중 하나다. 기계가 계산하는 문서의 유사도의 성능은 어떤 방법으로 수치화하여 표현했는지(DTM, Word2Vec), 문서 간의 단어들의 차이를 어떤 방법(유클리드의 거리, 코사인 유사도 등)으로 계산했는지에 달렸다.
💡 Vector Similarity 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/5_Vector%20Similarity.ipynb
06. 토픽 모델링(Topic Modeling)
토픽 모델링이란 기계 학습 및 자연어 처리 분야에서 토픽이라는 문서 집합의 추상적인 주제를 발견하기 위한 통계적 모델 중 하나로, 텍스트 본문의 숨겨진 의미구조를 발견하기 위해 사용되는 텍스트 마이닝 기법이다.
1) 잠재 의미 분석(Latent Semantic Analysis, LSA)
LSA는 정확히는 토픽 모델링을 위해 최적화 된 알고리즘은 아니지만, 토픽 모델링이라는 분야에 아이디어를 제공한 알고리즘이라고 볼 수 있다. 이에 토픽 모델링 알고리즘인 LDA에 앞서 배워보도록 하겠다. 뒤에서 배우게 되는 LDA는 LSA의 단점을 개선하여 탄생한 알고리즘으로 토픽 모델링에 보다 적합한 알고리즘이다.
BoW에 기반한 DTM이나 TF-IDF는 기본적으로 단어의 빈도 수를 이용한 수치화 방법이기 때문에 단어의 의미를 고려하지 못한다는 단점이 있었다. (이를 토픽 모델링 관점에서는 단어의 토픽을 고려하지 못한다고도 한다.) 이를 위한 대안으로 DTM의 잠재된(Latent) 의미를 이끌어내는 방법으로 잠재 의미 분석(Latent Semantic Analysis, LSA)이라는 방법이 있다. 잠재 의미 분석(Latent Semantic Indexing, LSI)이라고 부르기도 한다.
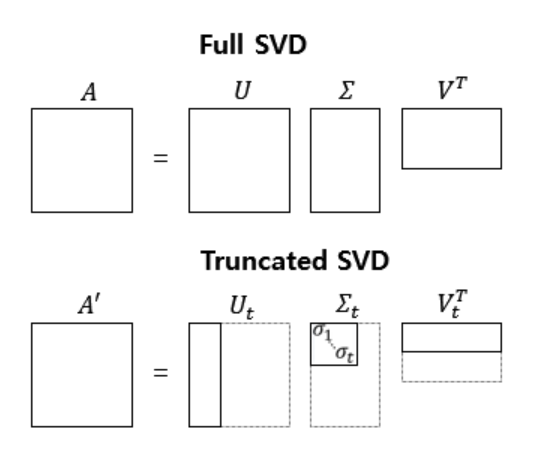
=> 특이값 분해(Singular Value Decomposition, SVD) : A가 m x n 행렬일때, 3개의 행렬의 곱으로 분해(decomposition)하는 것을 말한다.
=> LSA의 경우 풀 SVD에서 나온 3개의 행렬에서 일부 벡터들을 삭제시킨 절단된 SVD(truncated SVD)를 사용한다. full SVD를 사용하는게 아님!
=> 절단된 SVD는 대각 행렬의 대각 원소의 값중에서 상위값 t개만 남게 된다. 여기서 t를 선택하는 것은 쉽지 않은 일이다. t를 크게 잡으면 기존의 행렬
A로부터 다양한 의미를 가져갈 수 있지만, t를 작게 잡아야만 노이즈를 제거할 수 있기 때문이다. 이렇게 일부 벡터들을 삭제하는 것을
데이터의 차원을 줄인다고도 말하는데, 데이터의 차원을 줄이게되면 당연히 풀 SVD를 했을때보다 직관적으로 계산비용이 낮아지는 효과를 얻을 수 있다.
여기서 계산비용이 낮아지는 것 외에도 상대적으로 중요하지 않은 정보를 삭제하는 효과를 가지고 있는데 이는 설명력이 높은 정보를 남긴다는 의미를
가지고 있다. 즉, 기존 행렬에서는 드러나지 않았던 심층적인 의미를 확인할수 있게 해준다.
2) 잠재 디리클레 할당(Latent Dirichlet Allocation, LDA)
LDA는 문서의 집합으로부터 어떤 토픽이 존재하는지를 알아내기 위한 알고리즘이다.
LDA는 앞서 배운 빈도수 기반의 표현 방법인 BoW의 행렬 DTM 또는 TF-IDF 행렬을 입력으로 하는데, 이로부터 알 수 있는 사실은 LDA는 단어의 순서는 신경쓰지 않겠다는 것이다.
=> LSA : DTM을 차원 축소 하여 축소 차원에서 근접 단어들을 토픽으로 묶는다.
=> LDA : 단어가 특정 토픽에 존재할 확률과 문서에 특정 토픽이 존재할 확률을 결합확률로 추정하여 토픽을 추출한다.
💡 Topic Modeling 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/6_Topic%20Modeling.ipynb
07. 머신 러닝(Machine Learning)개요
하이퍼파라미터(초매개변수)는 모델의 성능에 영향을 주는 매개변수들을 말하고 보통 사용자가 직접 정해줄수 있는 변수를 말한다. 예를 들어 경사하강법에서 학습률(learning rate)이나 딥러닝에서 은닉층의 수, 뉴런의 수등을 말한다. 반면에 매개변수는 가중치와 편향과 같은 학습을 통해 바뀌어져가는 변수를 말하며 사용자가 결정해주는 값이 아니라 모델이 학습하는 과정에서 얻어지는 값을 말한다.
1) 개념 설명
=> 지도 학습: 레이블(Label)이라는 정답과 함께 학습하는 것을 말한다.
=> 비지도 학습: 레이블이 없이 학습하는 것을 말한다. 토픽 모델링의 LDA가 이에 속한다.
=> 머신 러닝에서는 맞춘 문제수를 전체 문제수로 나눈 값을 정확도(Accuracy)라고 한다. 하지만 정확도는 맞춘 결과와 틀린 결과에 대해
세부적인 내용을 알려주지 않는다. 예를 들어
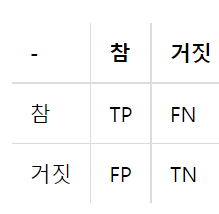
일때
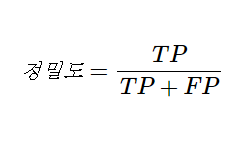
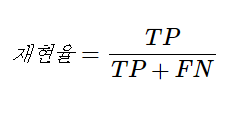
이렇게 표현할수 있다.
=> 머신러닝에서 과적합(Overfitting)이나 과소적합(Underfitting)이되지 않고 적합(fitting)이 되도록 해야 한다.
2) 선형 회귀(Linear Regression)
변수 x의 값은 독립적으로 변할 수 있는 것에 반해, y값은 계속해서 x의 값에 의해서, 종속적으로 결정되므로 x를 독립 변수, y를 종속 변수라고도 한다. 선형 회귀는 한 개 이상의 독립 변수 x와 y의 선형 관계를 모델링한다. 만약, 독립 변수 가 1개라면 단순 선형 회귀라고 한다. 그게 아니라면 다중 선형 회귀라고 한다.
=> 비용함수(Cost function): 평균 제곱 오차(MSE)
=> 옵티마이저(Optimizer): 경사하강법(Gradient Descent)
3) 로지스틱 회귀(Logistic Regression)
=> 비용함수: 크로스 엔트로피 함수
4) 소프트맥스 회귀(Softmax Regression)
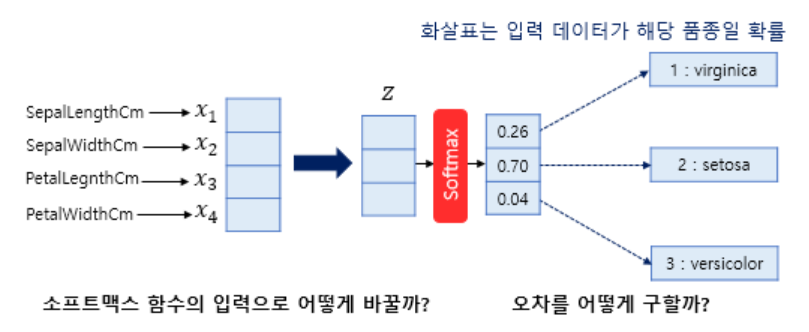
앞서 로지스틱 회귀를 통해 2개의 선택지 중에서 1개를 고르는 이진 분류(Binary Classification)를 풀었다. 이번엔 3개 이상의 선택지중에서
1개를 고르는 다중 클래스 분류 문제를 위한 소프트맥스 회귀를 알아본다.
=> 비용함수: 크로스 엔트로피 함수
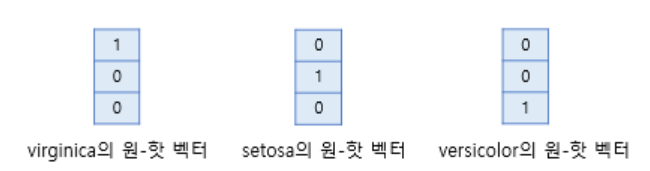
=> 오차 계산방법에 대해 소프트맥스 회귀에서는 실제값을 원-핫 벡터로 표현한다.
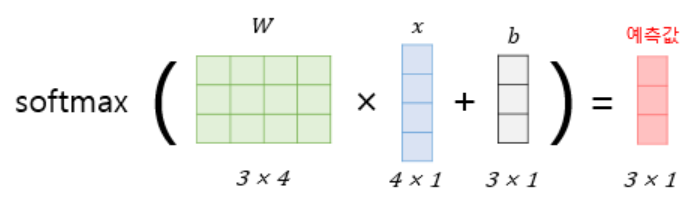
💡 Machine Learning 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/7_Machine%20Learning.ipynb
08. 딥 러닝(Deep Learning)개요
딥 러닝의 기본 구조인 인공 신경망(Artificial Neural Network)의 역사는 생각보다 오래되었다. 딥 러닝을 보다 손쉽게 이해하기 위해서 1957년에 등장한 초기 인공 신경망부터 학습해보겠다. 이 챕터에서는 초기 신경망인 퍼셉트론(Perceptron)부터 피드 포워드 신경망 언어 모델의 정의, 그리고 기본적인 케라스의 사용법에 대해서 배워본다.
1) 퍼셉트론(Perceptron)
퍼셉트론(Perceptron)은 프랑크 로젠블라트(Frank Rosenblatt)가 1957년에 제안한 초기 형태의 인공 신경망으로 다수의 입력으로부터 하나의 결과를 내보내는 알고리즘이다. 퍼셉트론은 실제 뇌를 구성하는 신경 세포 뉴런의 동작과 유사한데, 신경 세포 뉴런의 그림을 먼저 보도록 하겠다. 뉴런은 가지돌기에서 신호를 받아들이고, 이 신호가 일정치 이상의 크기를 가지면 축삭돌기를 통해서 신호를 전달한다.
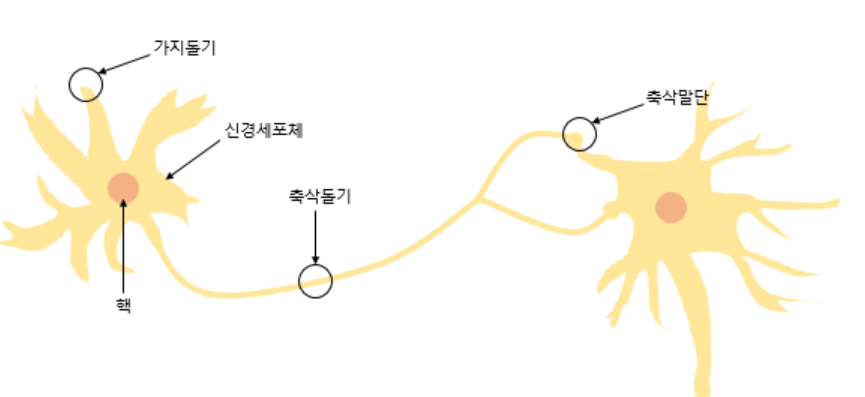
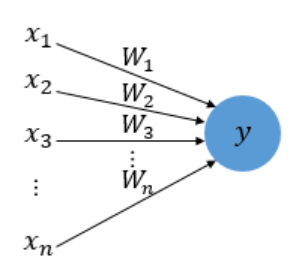
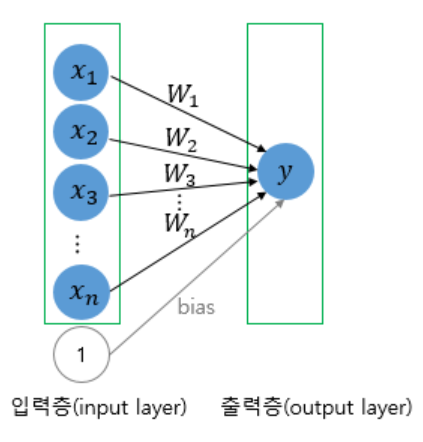
신경 세포 뉴런의 입력 신호와 출력 신호가 퍼셉트론에서 각각 입력값과 출력값에 해당된다. x는 입력값을 의미하며 W는 가중치(Weight), y는 출력값이다.
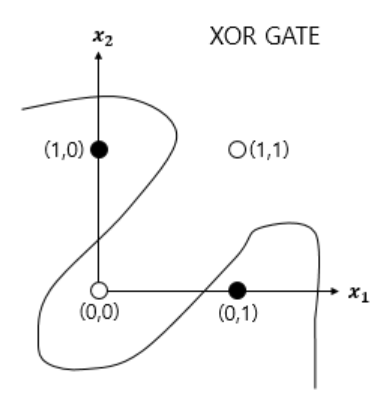
=> 단층 퍼셉트론(Single-Layer Perceptron) : 입력층(input layer)과 출력층(output layer)로 되어있다. 단층 퍼셉트론을 이용하면 AND,NAND, OR 게이트를
쉽게 구현할수 있다. 그러나 XOR 게이트는 구현이 불가능하다. 그 이유는 단층 퍼셉트론은 직선 하나로 두 영역을 나눌수 있는 문제에 대해서만 구현가능하기 때문이다. 이를 위해선
다층 퍼셉트론이 필요하다.
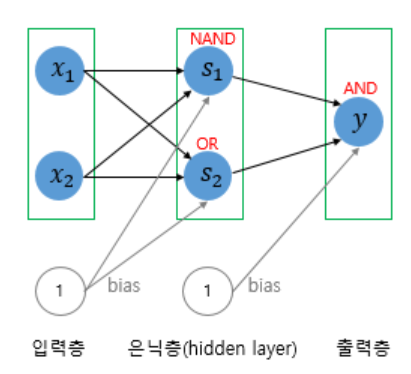
=> 다층 퍼셉트론(MultiLayer Perceptron, MLP) : 입력층과 출력층 사이에 존재하는 층인 은닉층(hidden layer)이 있다. 다층 퍼셉트론은 본래 은닉층이 1개이상인 퍼셉트론을
말한다. 은닉층이 2개 이상인 신경망을 심층 신경망(Deep Neural Network, DNN)이라고 한다.
2) 인공 신경망(Artificial Neural Network) 훑어보기
=> 피드 포워드 신경망(Feed-Forward Neural Network, FFNN)
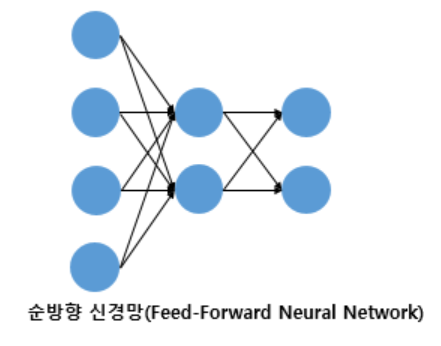
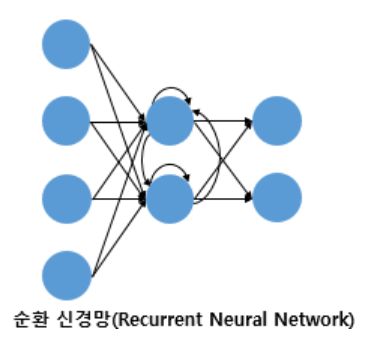
RNN은 FFNN과 달리 은닉층의 출력값을 출력층으로도 값을 보내지만 동시에 은닉층의 입력으로 사용된다.
=> 전결합층(Fully-connected layer, FC, Dense layer) : 어떤 층의 모든 뉴런이 이전 층의 모든 뉴런과 연결돼 있는 층을 말한다.
=> 활성화 함수(Activation Function) : 비선형 함수(직선 1개로는 그릴수 없는 함수)여야 한다. 앞서 생각했던 계단함수도 마찬가지로 비선형 함수이며 활성화 함수다.
인공신경망의 능력을 높이기 위해선 은닉층을 계속해서 추가해줘야 하는데 만약 선형함수로 사용하면 y(x)=kx와 같이 표현이 결국 되므로 은닉층을 여러번 추가해도
1번 추가한것과 차이를 줄수 없다.
=> 행렬의 곱셈을 이용한 순전파(Forward Propagation)
3) 딥러닝의 학습 방법
=> 순전파
=> 손실 함수 : MSE, Cross-Entroy등과 같은 함수가 있다.
=> 옵티마이저 : 여기서 배치란 가중치 등의 매개 변수의 값을 조정하기 위해 사용하는 데이터의 양을 말한다. 옵티마이저로는 배치 경사 하강법/
확률적 경사 하강법/ 미니 배치 경사 하강법/ 모멘텀/ 아다그라드 /알엠에스프롭 /아담 등이 있다.
=> 역전파 : 인공신경망의 학습은 오차를 최소화하는 가중치를 찾는 목적으로 순전파와 역전파를 반복하는 것을 말한다.
=> 에포크 : 인공 신경망에서 전체 데이터에 대해 순전파와 역전파가 끝난 상태를 말한다.
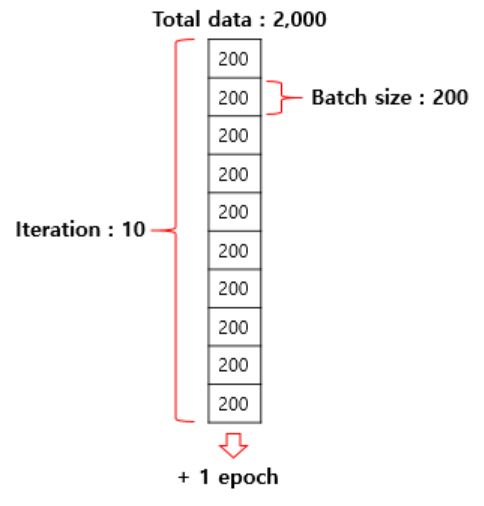
=> 배치 크기 : 몇 개의 데이터 단위로 매개변수를 업데이트 하는지를 말한다. 기계 입장에서는 실제값과 예측값으로부터 오차를
계산하고 옵티마이저가 매개변수를 업데이트한다. 이때 주의할점이 있다. 예를 들어 전체 데이터가 2000일때 배치 크기를 200으로 준다면
배치의 수(이터레이션)는 10이다.
=> 이터레이션 : 한번의 에포크를 끝내기 위해서 필요한 배치의 수를 말한다.
8) 케라스 서브클래싱 API
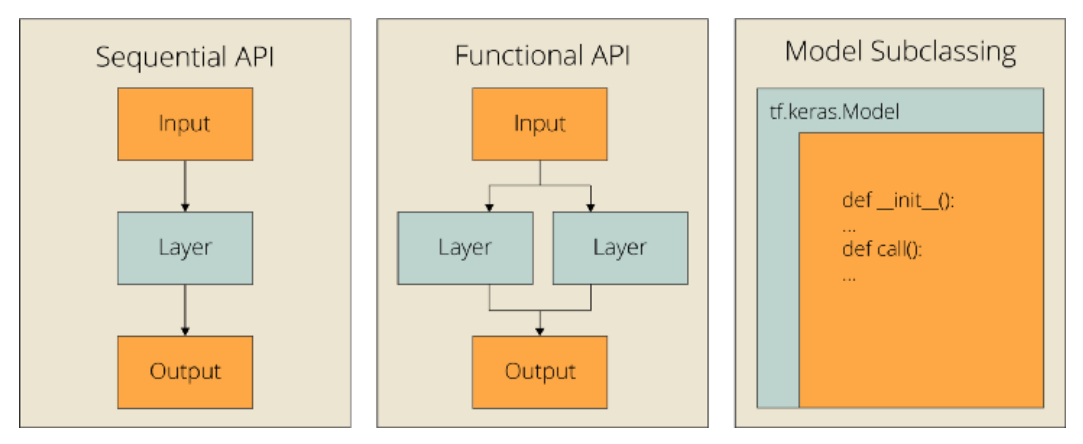
케라스의 구현 방식에는 Sequential API, Functional API 외에도 Subclassing API라는 구현방식이 존재한다.
=> Sequential API : 단순하게 층을 쌓는방식으로 쉽지만 다수의 입출력에는 어렵다.
=> Functional API : Sequential API로는 구현하기 어려운 복잡한 모델들을 구현할수 있지만 입력의 크기를 명시한 입력층을 모델의 앞단에 정의해야 한다.
=> Subclassing API : Functional API로도 구현할수 없는 모델들조차 구현가능하지만 코드사용이 가장 까다롭다. 객체지향프로그래밍에 익숙해야한다.
💡 Deep Learning 실습 =>
https://github.com/heeyeonkoo99/Deep-learning_study/blob/master/%EC%8B%A4%EC%8A%B5/8_Deep%20Learning.ipynb
09. 순환 신경망(Recurrent Neural Network)
앞서 배운 피드 포워드 신경망은 입력의 길이가 고정되어 있어 자연어 처리를 위한 신경망으로는 한계가 있었다. 결국 다양한 길이의 입력 시퀀스를 처리할수 있는 인공신경망이 필요하게 되었고 그래서 RNN, LSTM에 대해 알아본다.
1) 순환 신경망(RNN)
RNN은 입/출력을 시퀀스 단위로 처리하는 시퀀스(Sequence) 모델이다. 참고로 재귀 신경망(Recursive Neural Network)와는 전혀 다르다. 곧이어 배울 LSTM,GRU
또한 근본적으로 RNN에 속한다.
=> 피드 포워드 신경망에서는 뉴런이라는 단위를 사용했지만 RNN에서는 뉴런이라는 단위보단 입력층과 출력층에서는
각각 입력 벡터와 출력 벡터, 은닉층에서는 은닉 상태라는 표현을 주로 사용한다.
=> RNN에서는 ‘일대다’(이미지 캡셔닝),’다대일’(스팸 메일 분류),’다대다’(번역기)와 같은 다양한 용도로 사용할수 있다.
=> 케라스, 파이썬 등으로 구현할수 있다.
=> 깊은 순환신경망(은닉층을 더 추가함으로써), 양방향 순환 신경망등이 있다.
2) 장단기 메모리(Long Short-Term Memory, LSTM)
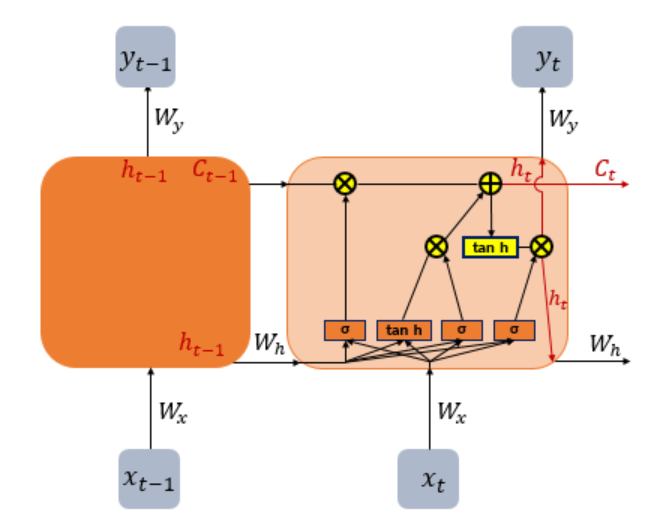
바닐라 RNN에는 출력 결과가 이전의 계산 결과에 의존하지만 비교적 짧은 시퀀스에 대해서만 효과를 보인다. 즉 어쩌면 가장 중요한
정보가 시점의 앞 쪽에 위치할수 있는데 뒤로 갈수록 손실된다는 것이다. LSTM은 은닉츠의 메모리 셀에 입력 게이트, 망각 게이트, 출력 게이트를 추가하여 불필요한 기억을 지우고 기억해야할것들을 정한다. 즉 LSTM은 은닉상태를 계산하는 식이 전통적인 RNN보다는 조금 더 복잡해졌으며 셀상태라는 값을 추가한것이다.
3) 게이트 순환 유닛(Gated Recurrent Unit, GRU)
GRU는 LSTM의 장기 의존성 문제에 대한 해결책을 유지하면서 은닉상태를 업데이트하는 계산을 줄였다.
=> LSTM에서는 출력/입력/삭제 게이트라는 3개의 게이트가 존재했는데 GRU는 업데이트/리셋 게이트 두가지 게이트가 존재한다.
=> 둘중 어느것이 성능면에서 더 낫다라고 단정지어 말할순 없다.
5) RNN 언어 모델(Recurrent Neural Network Language Model, RNNLM)
=> RNN 훈련 기법: 교사 강요(teacher forcing)- 테스트 과정에서 t시점의 출력이 t+1 시점의 입력으로 사용되는 RNN모델을 훈련시킬때 사용하는
훈련 기법이다. 훈련할때 교사강요를 사용할 경우, 모델이 t시점에서 예측한 값을 t+1시점에 입력으로 사용하지 않고, t시점의 레이블. 즉
실제 알고있는 정답을 t+1시점의 입력으로 사용한다.
=> 훈련 과정동안 출력층에서 사용하는 활성화 함수는 소프트맥스 함수다. 손실함수로는 크로스 엔트로피 함수를 사용한다.
10. 워드 임베딩(Word Embedding)
단어를 표현하는 방법에 따라 자연어 처리의 성능이 크게 달라지기에 이에 대한 연구가 많이 있고 여러 방법들이 알려져 있다. 최근에는 단어의 의미를 벡터화시킬수 있는 워드투벡터(Word2Vec)와 글로브(Glove)가 많이 사용되고 있다. 이번 챕터에서는 전통적 방법의 한계를 개선시킨 워드 임베딩방법론에 대해 배워본다.
1) 워드임베딩
=> 희소 표현 : 앞서 원-핫 인코딩을 통해서 나온 원-핫 벡터들은 표현하고자 하는 단어의 인덱스의 값만 1이고, 나머지 인덱스에서는
전부 0으로 표현되는 벡터 표현 방법이었다. 이렇게 벡터 또는 행렬(matrix)의 값이 대부분이 0으로 표현되는 방법을 희소표현이라하고
즉 원-핫 벡터는 희소벡터이다. 이 표현은 단어의 개수가 늘어나면 벡터의 차원이 한없이 커져 공간적 낭비를 일으킨다.
=> 밀집 표현 : 희소 표현과는 반대되며, 벡터의 차원을 단어 집합의 크기로 상정하지 않고 사용자가 설정한 값으로 모든 단어의
벡터 표현의 차원을 맞춘다. 이 과정에서 더이상 0과 1만 가진 값이 아니라 실수값을 가지게 된다.
=> 여기서 단어를 밀집 벡터의 형태로 표현하는 방법을 워드 임베딩이라고 한다.
| 원-핫 벡터 | 임베딩 벡터 | |
|---|---|---|
| 차원 | 고차원(단어 집합의 크기) | 저차원 |
| 다른 표현 | 희소 벡터의 일종 | 밀집 벡터의 일종 |
| 표현 방법 | 수동 | 훈련 데이터로부터 학습함 |
| 값의 타입 | 1과 0 | 실수 |
2) 워드투벡터
원-핫 벡터는 단어 간 유사도를 계산할 수 없다는 단점이 있어서 단어간 유사도를 반영할수 있도록 단어의 의미를 벡터화 할수 있는 방법이 필요하다.
그 대표적인 방법이 워드투벡터다.
=> 희소표현이 고차원에 각 차원이 분리된 표현 방법이었다면, 분산 표현은 저차원에 단어의 의미를 여러 차원에다가 분산하여 표현한다.
=> 워드투벡터는 CROW와 Skip-Gram 두가지 방식이 있다.
=> 참고로 워드투벡터는 딥러닝모델이 아니다. 보통 딥러닝이라 하면 입력층과 출력층 사이의 은닉층 개수가 충분히 쌓인 신경망을
학습할때를 말하는데 워드투벡터는 입력층과 출력층 사이에 하나의 은닉층만이 존재하며 활성화 함수가 없다.-얕은 신경망(Shallow Neural Network)
=> CROW: 주변에 있는 단어들을 가지고 중간에 있는 단어들을 예측하는 방법이다. ‘슬라이딩 윈도우’를 통해 데이터셋을 만든다.
=> Skip-Gram: 중간에 있는 단어로 주변 단어들을 예측하는 방법이다.
=> NNLM은 단어간 유사도를 구할수 있또록 워드 임베딩의 개념을 도입했고, NNLM의 느린 학습 속도와 정확도를 개선하여 탄생한것이
워드투벡터다. NNLM은 언어모델이므로 단음 단어를 예측하지만 워드투벡터는 워드 임베딩 자체가 목적이므로 다음 단어가 아닌 중심 단어를
예측하여 학습한다. NNLM보다 학습 속도가 빠르다.
4) 네거티브 샘플링을 이용한 Word2Vec 구현
네거티브 샘플링은 Word2Vec이 학습 과정에서 전체 단어 집합이 아니라 일부 단어 집합에만 집중할수 있도록 하는 방법이다.
(“고양이/귀여운/돈까스”의 예시를 생각해보자!) 하나의 중심단어에 대해서 전체 단어 집합보다 훨씬 작은 단어 집합을 만들어놓고
마지막 단계를 이진 분류문제로 변환한다. 주변 단어들을 긍정(positive), 랜덤으로 샘플링 된 단어들을 부정(negative)으로 레이블링한다면
이진 분류문제를 위한 데이터셋이된다.
5) 글로브(GloVe)
글로브는 카운트 기반과 예측기반을 모두 사용하는 방법론이다. 기존 카운트 기반의 LSA와 예측 기반의 Word2Vec의
단점을 지적하며 이를 보완키위한 목적으로 나왔다.
=> 윈도우 기반 동시 등장 행렬 : 단어의 동시 등장 행렬은 행과 열을 전체 단어 집합의 단어들로 구성하고, i 단어의 윈도우 크기(Window Size) 내에서 k 단어가 등장한 횟수를 i행 k열에 기재한 행렬을 말한다.
=> 동시 등장 확률 : 동시 등장 확률 는 동시 등장 행렬로부터 특정 단어 i의 전체 등장 횟수를 카운트하고, 특정 단어 i가 등장했을 때 어떤 단어 k가 등장한 횟수를 카운트하여 계산한 조건부 확률이다.
9) 엘모(Embeddings from Language Model, ELMo)
ELMo(Embeddings from Language Model)는 2018년에 제안된 새로운 워드 임베딩 방법론이다. (비교적 최근이네) ELMo라는 이름은 세서미 스트리트라는 미국 인형극의 케릭터 이름이기도 한데, 뒤에서 배우게 되는 BERT나 최근 마이크로소프트가 사용한 Big Bird라는 NLP 모델 또한 ELMo에 이어 세서미 스트리트의 케릭터의 이름을 사용했다. ELMo는 Embeddings from Language Model의 약자다. 해석하면 ‘언어 모델로 하는 임베딩’이다. ELMo의 가장 큰 특징은 사전 훈련된 언어 모델(Pre-trained language model)을 사용한다는 점이다. 이는 ELMo의 이름에 LM이 들어간 이유다.
Bank라는 단어를 생각해봅시다. Bank Account(은행 계좌)와 River Bank(강둑)에서의 Bank는 전혀 다른 의미를 가지는데, Word2Vec이나 GloVe 등으로 표현된 임베딩 벡터들은 이를 제대로 반영하지 못한다는 단점이 있습니다. 예를 들어서 Word2Vec이나 GloVe 등의 임베딩 방법론으로 Bank란 단어를 [0.2 0.8 -1.2]라는 임베딩 벡터로 임베딩하였다고 하면, 이 단어는 Bank Account(은행 계좌)와 River Bank(강둑)에서의 Bank는 전혀 다른 의미임에도 불구하고 두 가지 상황 모두에서 [0.2 0.8 -1.2]의 벡터가 사용됩니다. 그렇다면 같은 표기의 단어라도 문맥에 따라서 다르게 워드 임베딩을 할 수 있으면 자연어 처리의 성능이 더 올라가지 않을까요? 단어를 임베딩하기 전에 전체 문장을 고려해서 임베딩을 하겠다는 것이죠. 그래서 탄생한 것이 문맥을 반영한 워드 임베딩(Contextualized Word Embedding)입니다.
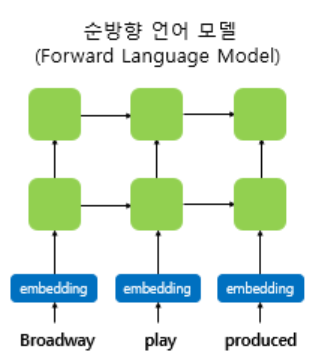
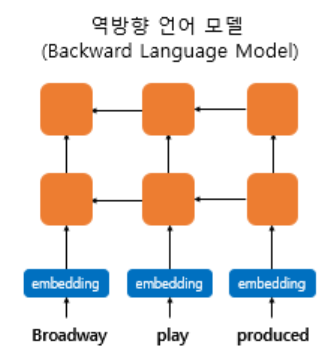
=> RNN 언어 모델은 문장으부터 단어 단위로 입력을 받는데, RNN 내부의 은닉 상태는 시점(time-step)이 지날수록 점점 업데이트된다. 이것은 RNN의 기본개념이다. 그런데 ELMo는 순방향 RNN뿐만 아니라 반대방향으로 문장을 스캔하는 RNN 또한 활용한다. 이를 biLM(Bidirectional Language Model)이라고 한다. ELMo에서 말하는 biLM은 기본적으로 다층 구조(Multi-layer)를 전제로 한다. 은닉층이 최소 2개 이상이라는 의미다. 아래의 그림은 은닉층이 2개인 순방향 언어 모델과 역방향 언어 모델의 모습을 보여준다.
11. RNN을 이용한 텍스트 분류(Text Classification)
텍스트 분류(Text Classification)은 텍스트를 입력으로 받아, 텍스트가 어떤 종류의 범주(Class)에 속하는지를 구분하는 작업을 구한다. 텍스트 분류에서 분류해야할 범주가 두 가지라면 이진 분류(Binary Classification)라고 하며, 세 가지 이상이라면 다중 클래스 분류(Multi-Class Classification)라고 한다. 일반 메일과 스팸 메일 두 개의 범주를 가진 스팸 메일 분류는 이진 분류에 해당된다. 이 챕터에서는 머신 러닝 방법인 나이브 베이즈 분류와 인공 신경망 방법인 바닐라 RNN과 LSTM을 이용해서 텍스트 분류를 진행해보도록 하겠다.
=> 텍스트 분류는 RNN의 다-대-일(Many-to-One) 문제에 속한다. 즉, 텍스트 분류는 모든 시점(time step)에 대해서 입력을 받지만 최종 시점의 RNN 셀만이 은닉 상태를 출력하고, 이것이 출력층으로 가서 활성화 함수를 통해 정답을 고르는 문제가 된다.
이 때 두 개의 선택지 중에서 정답를 고르는 이진 분류(Binary Classification) 문제라고 하며, 세 개 이상의 선택지 중에서 정답을 고르는 다중 클래스 분류(Multi-Class Classification) 문제라고 한다. 이 두 문제에서는 각각 문제에 맞는 다른 활성화 함수와 손실 함수를 사용할 것이다.
이진 분류의 문제의 경우 출력층의 활성화 함수로 시그모이드 함수를, 손실 함수로 binary_crossentropy를 사용한다. 반면, 다중 클래스 문제라면 출력층의 활성화 함수로 소프트맥스 함수를, 손실 함수로 categorical_crossentropy를 사용한다. 또한, 다중 클래스 분류 문제의 경우에는 클래스가 N개라면 출력층에 해당되는 밀집층(dense layer)의 크기는 N으로 한다. 즉, 출력층의 뉴런의 수는 N개다.
=> 스팸 메일 분류하기(이진 분류문제)/ 로이터 뉴스 분리하기(다중 클래스 문제)
=> 나이브 베이즈 분류기: 텍스트 분류를 위해 전통적으로 사용되는 분류기이며 인공 신경망 알고리즘에는 속하지 않는다. 나이브 베이즈 분류기를 이해하기 위해서는 우선 베이즈의 정리(Bayes’ theorem)를 이해할 필요가 있다. 베이즈 정리는 조건부 확률을 계산하는 방법 중 하나다.
=> P(A)가 A가 일어날 확률, P(B)가 B가 일어날 확률, P(B|A)가 A가 일어나고나서 B가 일어날 확률, P(A|B)가 B가 일어나고나서 A가 일어날 확률이라고 해본다. 이때 P(B|A)를 쉽게 구할 수 있는 상황이라면, 아래와 같은 식을 통해 를 구할 수 있다.
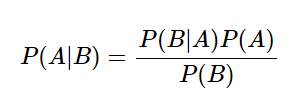
12. NLP를 위한 합성곱 신경망(Convolution Neural Network)
합성곱 신경망은 주로 이미지, 비전 분야에서 사용되는 알고리즘이지만, 이를 응용해서 자연어 처리에 사용하기 위한 시도들이 있었다. 이번 챕터에서는 합성곱 신경망을 이해하고, 합성곱 신경망을 이용한 자연어 처리에 대해서 학습한다.
📌 참고로 앞선 챕터에서는 파이썬으로 실습한 github 주소를 같이 올리기도 했으나, 개념을 이해하는 것보다 코드를 올리는 것에 신경쓰다 보니 주객이 전도된것 같아 개념을 제대로 이해하지 못하고 넘어가는 느낌이 들었다. 따라서 앞으로는 개념내용만을 상세히 적도록 하겠다. 코드짜는 것은 그 이후에 해도 충분할것 같다.
1) 합성곱 신경망(Convolution Neural Network)
합성곱 신경망은 이미지 처리에 탁월한 성능을 보이는 신경망이며 자연어 처리에서도 사용된다. 크게 합성곱측(Convolution layer)과 풀링층(Pooling layer)로 구성된다.
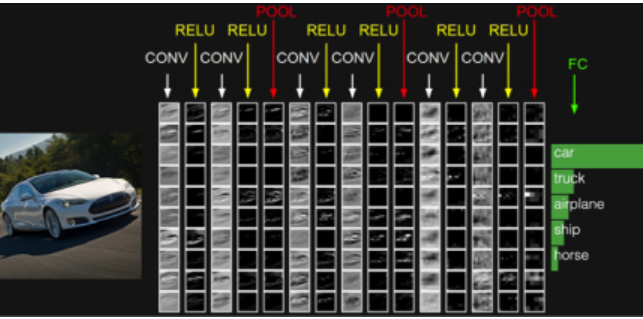
위의 그림에서 CONV는 합성곱 연상르 의미하고, 합성곱 연산의 결과가 활성화 함수 ReLU를 지난다. 이 두 과정을 합성곱층이라고 한다. 그후에 POOL이라는 구간을 지나는데
이는 풀링 연산을 의미하며 풀링층이라고 한다.
=> 채널(Channel) : 기계는 글자나 이미지보다 숫자. 다시 말해, 텐서를 더 잘 처리할수 있다. 이미지는 (높이, 너비, 채널)이라는 3차원 텐서다. 여기서 높이는 이미지의 세로 방향 픽셀 수,
너비는 이미지의 가로 방향 픽셀 수, 채널은 색 성분을 의미한다. 흑백 이미지는 채널 수가 1이며, 각 픽셀은 0부터 255 사이의 값을 가진다. 예를 들어 28 x 28픽셀의 흑백 손글씨 데이터가 있다면
(28 x 28 x 1)의 크기를 가지는 3차원 텐서라고 볼수 있다.
=> 합성곱 연산: 합성곱은 영어로 컨볼루션이라고도 불리는데, 커널(kernel) 또는 필터(filter)라는 n x m 크기의 행렬로 높이(height)x너비(width)크기의 이미지를 처음부터
끝까지 겹치며 훑으면서 n x m 크기의 겹쳐지는 부분의 각 이미지와 커널의 원소의 값을 곱해서 모두 더한 값을 출력으로 하는 것을 말한다. 이때 이미지의 가장 왼쪽 위부터 가장 오른쪽까지
순차적으로 훑는다. 일반적으로 커널은 3 x 3 또는 5 x 5를 사용한다. 입력으로부터 커널을 사용하여 합성곱 연산을 통해 나온 결과를 특성 맵(feature map)이라고 한다. 커널의 이동범위를
스트라이드(stride)라고 한다.
=> 패딩(padding) : 만약, 합성곱 층을 여러개 쌓았다면 최종적으로 얻은 특성 맵은 초기 입력보다 매우 작아진 상태가 되버린다. 합성곱 연산 이후에도 특성 맵의 크기가 입력의 크기와 동일하게 유지되도록 하고 싶다면 패딩(padding)을 사용하면 된다. 주로 값을 0으로 채우는 제로 패딩을 사용한다.
=> 다수의 채널을 가질 경우의 합성곱 연산(3차원 텐서의 합성곱 연산) : 다수의 채널을 가진 입력 데이터를 가지고 합성곱 연산을 한다고 하면
커널의 채널 수도 입력의 채널 수만큼 존재해야 한다. 즉 입력 데이터의 채널 수와 커널의 채널수는 같아야 한다. 아래 그림처럼 각 채널 간 합성곱 연산을 마치고, 그 결과를 모두 더해서
하나의 채널을 가지는 특성 맵을 만든다. 이때 사용되는 커널은 3개의 커널이 아니라 3개의 채널을 가진 1개의 커널이라는 점이다.
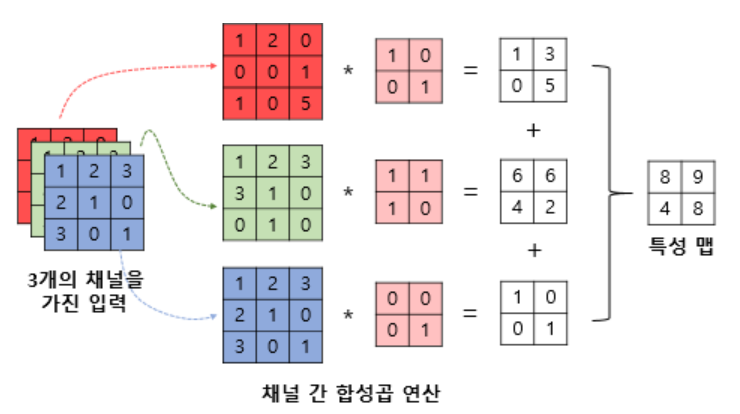
=> 풀링(Pooling) : 일반적으로 합성곱 층(합성곱 연산 + 활성화 함수) 다음에는 풀링 층을 추가하는 것이 일반적이다. 풀링 층에서는 특성 맵을 다운샘플링하여 특성 맵의 크기를 줄이는 풀링 연산이 이루어진다. 풀링 연산에는 일반적으로 최대 풀링(max pooling)과 평균 풀링(average pooling)이 사용된다. 풀링 연산에서도 합성곱 연산과 마찬가지로 커널과 스트라이드의 개념을 가진다. 위의 그림은 스트라이드가 2일 때, 2 × 2 크기 커널로 맥스 풀링 연산을 했을 때 특성맵이 절반의 크기로 다운샘플링되는 것을 보여준다. 맥스 풀링은 커널과 겹치는 영역 안에서 최대값을 추출하는 방식으로 다운샘플링한다.
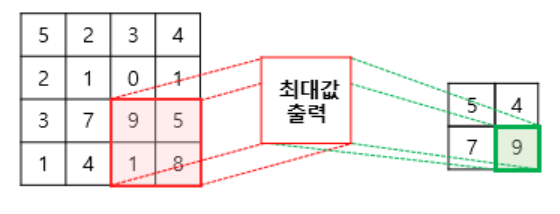
다른 풀링 기법인 평균 풀링은 최대값을 추출하는 것이 아니라 평균값을 추출하는 연산이 된다. 풀링 연산은 커널과 스트라이드 개념이 존재한다는 점에서 합성곱 연산과 유사하지만, 합성곱 연산과의 차이점은 학습해야 할 가중치가 없으며 연산 후에 채널 수가 변하지 않는다는 점이다. 풀링을 사용하면, 특성 맵의 크기가 줄어드므로 특성 맵의 가중치의 개수를 줄여준다.
2) 자연어 처리를 위한 1D CNN(1D Convolution Neural Network)
=> 2D 합성곱 : 합성곱 연산을 통해서 이미지의 특징을 추출하는 역할을 한다.
=> 1D 합성곱 : 자연어 처리에 사용되는 경우가 많은듯 싶다. 1D CNN도 입력이 되는 것이 각 단어가 벡터로 변환된 문장 행렬로 LSTM과 입력을 받는 형태는 동일하다. CNN에서의 커널은 신경망 관점에서는 가중치 행렬이므로 커널의 사이즈에 따라 학습하게 되는 파라미터의 수는 달라잔다. 1D CNN과 자연어 처리 관점에서는 커널의 사이즈에 따라서 참고하는 단어의 묶음의 크기가 달라진다. 이는 참고하는 n-gram이 달라진다고 볼 수 있다. 가령, 커널의 사이즈가 2라면 각 연산의 스텝에서 참고하는 것은 bigram이다. 커널의 사이즈가 3이라면 각 연산의 스텝에서 참고하는 것은 trigram이다.
7) 글자 임베딩(Character Embedding)
이번 챕터에서는 워드 임베딩과는 다른 방법으로 단어의 벡터 표현 방법을 얻으므로서 OOV 문제를 해결하는 글자 임베딩(Character Embedding)의 방법에 대해서 알아보겠다. 글 글자 임베딩은 사람의 이해능력을 흉내내는 알고리즘으로 각각 CNN과 RNN을 이용해 구현할수 있다.
13. 태깅 작업(Tagging Task)
단어 태깅 작업은 대표적으로 크게 두 가지가 있는데 각 단어의 유형이 사람, 장소, 단체 등 어떤 유형인지를 알아내는 개체명 인식(Named Entity Recognition)과 각 단어의 품사가 명사, 동사, 형용사 인지를 알아내는 품사 태깅(Part-of-Speech Tagging)이 있다. 이러한 작업은 챗봇, 기계 번역 등과 같은 자연어 처리 분야에서 메인 작업에 앞서 전처리 작업으로서 필요한 경우가 많지만, 전처리 작업이라고 쉬운 작업이 아니라 그 자체로도 까다로운 작업이 되어 많은 시간을 필요로 하는 작업이 되기도 한다.
=> 입력 시퀀스 X = [x1,x2,x3…,xn]에 대하여 레이블 시퀀스 y = [y1,y2,y3…,yn]를 각각 부여하는 작업을 시퀀스 레이블링 작업(Sequence Labeling Task)이라고 합니다. 태깅 작업은 대표적인 시퀀스 레이블링 작업이다.
=> CRF(Conditional Random Field) : CRF는 Conditional Random Field의 약자로 양방향 LSTM을 위해 탄생한 모델이 아니라 이전에 독자적으로 존재해왔던 모델이다. 이를 양방향 LSTM 모델 위에 하나의 층으로 추가하여, 양방향 LSTM + CRF 모델이 탄생했다.
14. 서브워드 토크나이저(Subword Tokenizer)
이번 챕터에서는 단어 토큰화에서 더 나아가 단어를 서브워드 단위까지 나누는 서브워드 토큰화에 대해 알아본다.
1) 바이트 페어 인코딩(Byte Pair Encoding, BPE)
기계에게 아무리 많은 단어를 학습시켜도, 세상의 모든 단어를 알려줄 수는 없는 노릇이다. 만약, 기계가 모르는 단어가 등장하면 그 단어를 단어 집합에 없는 단어란 의미에서 OOV(Out-Of-Vocabulary) 또는 UNK(Unknown Token)라고 표현한다. 기계가 문제를 풀 때, 모르는 단어가 등장하면 (사람도 마찬가지지만) 주어진 문제를 푸는 것이 까다로워 진다. 이와 같이 모르는 단어로 인해 문제를 푸는 것이 까다로워지는 상황을 OOV 문제라고 한다. 서브워드 분리(Subword segmenation) 작업은 하나의 단어는 더 작은 단위의 의미있는 여러 서브워드들(Ex) birthplace = birth + place)의 조합으로 구성된 경우가 많기 때문에, 하나의 단어를 여러 서브워드로 분리해서 단어를 인코딩 및 임베딩하겠다는 의도를 가진 전처리 작업이다. 이를 통해 OOV나 희귀 단어, 신조어와 같은 문제를 완화시킬 수 있다.
=> BPE 알고리즘 : 기본적으로 연속적으로 가장 많이 등장한 글자의 쌍을 찾아서 하나의 글자로 병합하는 방식을 수행한다.
aaabdaaabac
ZabdZabac
Z=aa
ZYdZYac
Y=ab
Z=aa
XdXac
X=ZY
Y=ab
Z=aa
=> 예를 들어, 테스트 과정에서 ‘lowest’란 단어가 등장한다면 기계는 이 단어를 학습한 적이 없으므로 해당 단어에 대해서 제대로 대응하지 못하는 OOV 문제가 발생한다. 그렇다면 BPE를 적용한다면 어떨까?
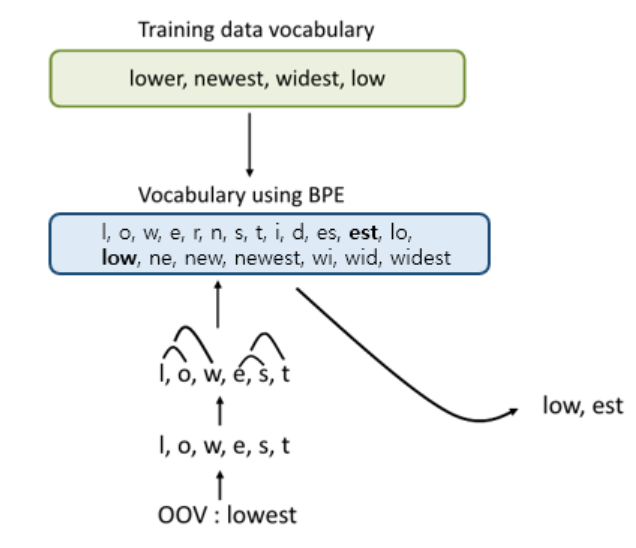
2) 센텐스피스(SentencePiece)
앞서 서브워드 토큰화를 위한 BPE(Byte Pair Encoding) 알고리즘과 그 외 BPE의 변형 알고리즘에 대해서 간단히 언급했다. 물론, 알고리즘을 아는 것도 중요하지만 어쩌면 그보다 더 중요한 것은 실무에서 바로 적용 가능하느냐의 문제일 수 있다. 이 경우 BPE를 포함하여 기타 서브워드 토크나이징 알고리즘들을 내장한 센텐스피스(SentencePiece)가 일반적으로 최선의 선택일 수 있다.
=> 센텐스피스: 내부 단어 분리를 위한 유용한 패키지로 구글의 센텐스피스(Sentencepiece)가 있다. 구글은 BPE 알고리즘과 Unigram Language Model Tokenizer를 구현한 센텐스피스를 깃허브에 공개했다. 내부 단어 분리 알고리즘을 사용하기 위해서, 데이터에 단어 토큰화를 먼저 진행한 상태여야 한다면 이 단어 분리 알고리즘을 모든 언어에 사용하는 것은 쉽지 않다. 영어와 달리 한국어와 같은 언어는 단어 토큰화부터가 쉽지 않기 때문이다. 그런데, 이런 사전 토큰화 작업(pretokenization)없이 전처리를 하지 않은 데이터(raw data)에 바로 단어 분리 토크나이저를 사용할 수 있다면, 이 토크나이저는 그 어떤 언어에도 적용할 수 있는 토크나이저가 될 것이다. 센텐스피스는 이 이점을 살려서 구현되었다. 센텐스피스는 사전 토큰화 작업없이 단어 분리 토큰화를 수행하므로 언어에 종속되지 않는다.
2) 서브워드텍스트인코더(SubwordTextEncoder)
SubwordTextEncoder는 텐서플로우를 통해 사용할 수 있는 서브워드 토크나이저아다. BPE와 유사한 알고리즘인 Wordpiece Model을 채택하였으며, 패키지를 통해 쉽게 단어들을 서브워드들로 분리할 수 있다.